Data Science | Machinelearning [ru]
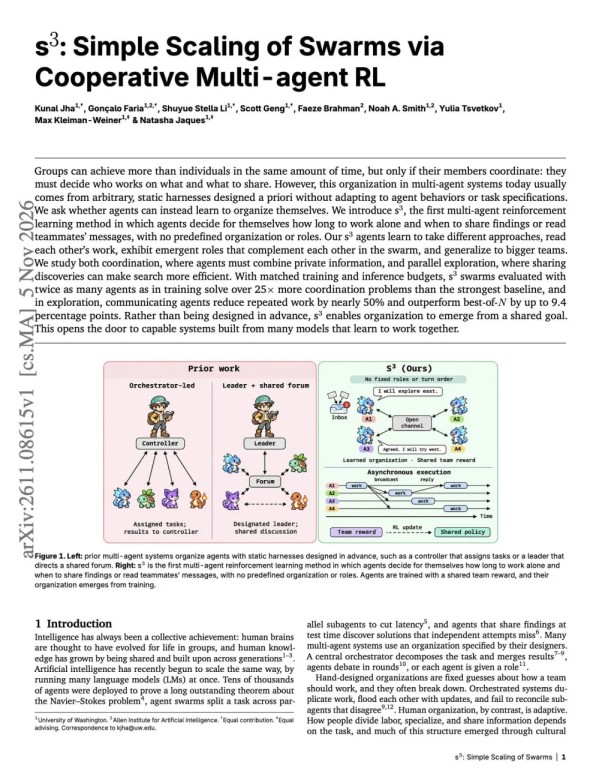 Вышло исследование про то, как масштабировать мультиагентные системы. Главный головняк в этой теме сейчас один: заставить толпу ИИ-агентов нормально координироваться и тащить задачу вместе, а не тянуть одеяло каждый в свою сторону.
Как обычно устроено? Разработчик сверху рисует план: вот этот агент делает вот это, вот тут они перекидываются данными. И вся эта схема, как правило, работает одинаково — хоть задачу поменяй, хоть нет.
Исследователи придумали подход s3. Правила сверху больше не нужны: агенты сами, через обучение с подкреплением, учатся договариваться о совместной работе. Сами решают, когда пора действовать в одиночку, когда скинуть результаты другим, а когда и к коллегам по команде постучаться. Роли никто заранее не раздаёт.
И цифры реально бодрят. При тех же затратах на обучение и инференс группы s3 — а на тестах их состав был вдвое больше, чем на обучении — закрыли более чем в 25 раз больше задач на координацию, чем лучший базовый метод. Когда решения искали параллельно, обмен данными между агентами почти вдвое срезал объём повторной работы и обогнал метод best-of-N на величину до 9,4 балла. И самое интересное: агенты сами разложили между собой взаимодополняющие роли, причём это разделение не развалилось даже когда команда выросла. Исследование:
👉 Telegram | Max | 🌥 Claude и другие ИИ
Если у вас установлено приложение,
вы можете сразу перейти в канал